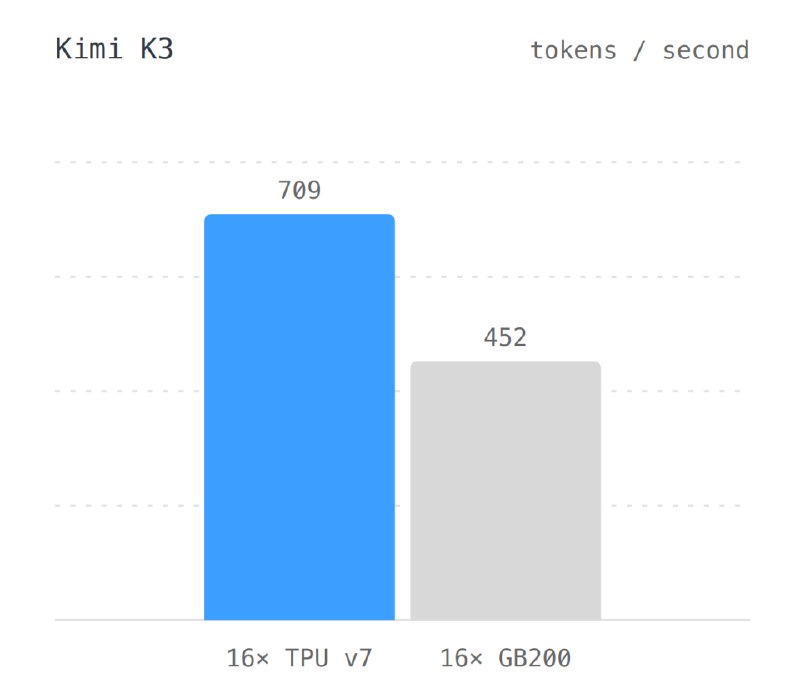
科技脉搏超大规模模型效率竞争升级:硅谷推出“巨内核”,中国团队推出“超级算子”浪潮信息发布元脑SD200 Ultra超节点,以128颗本土AI芯片承载2.8万亿参数Kimi K3,称实现5.85毫秒Token生成时延;海外团队Inferact则用16颗谷歌TPU v7和megakernel方案提升K3解码吞吐3小时前 × 超大规模模型效率竞争升级:硅谷推出“巨内核”,中国团队推出“超级算子”浪潮信息发布元脑SD200 Ultra超节点,以128颗本土AI芯片承载2.8万亿参数Kimi K3,称实现5.85毫秒Token生成时延;海外团队Inferact则用16颗谷歌TPU v7和megakernel方案提升K3解码吞吐。两者均通过算子融合、计算通信协同和内存优化降低推理开销,显示大模型竞争正延伸至系统软件、芯片互联与内存管理。来源:腾讯新闻3小时前